Тема
Проект и проектные списки
Проект WebVulnFinder объединяет накопленные знания и настройки одного объекта тестирования. Переключение проекта меняет данные во всех рабочих витринах и определяет, куда будут относиться новые HTTP-обмены, наблюдения и результаты проверок.
Для каждого проекта Burp Suite рекомендуется создавать отдельный проект WebVulnFinder. При создании идентификатор и название предлагаются на основе текущего проекта Burp Suite; отображаемое имя впоследствии можно изменить без потери накопленных данных.
Код проекта должен содержать от 4 до 64 символов: латинские буквы, цифры, дефис - и подчёркивание _. Первый символ — буква или цифра. Например: client_2026-prod. В отображаемом названии можно использовать русский текст и пробелы.
Все действия с проектом собраны в меню «…» возле списка: создание, переименование, режим «Только чтение», информация, очистка и удаление.
Только чтение
Включите «Только чтение» в меню проекта, чтобы сохранить собранную базу знаний без дальнейших изменений. Проект остаётся доступен в списке с отметкой режима: можно просматривать, искать и экспортировать данные, менять название и настройки. Сохранение новых HTTP-обменов, запись результатов анализа и редактирование наблюдений и строк приостановлены. Автоматическое пополнение также прекращается.
Чтобы продолжить работу, очистить или удалить проект, сначала снимите «Только чтение». Во время незавершённой очистки изменить режим нельзя.
Очистка проекта
Откройте меню «…» возле списка проектов, выберите «Очистить проект» и подтвердите действие. Задание принимается сервером и продолжается после закрытия Burp. После перезапуска сервера незавершённая очистка автоматически не продолжается. Очистка удаляет доступные вам HTTP-обмены, наблюдения, обнаруженные строки и связанные исходники выбранного проекта. Недоступные объекты и данные, которые ещё нужны оставшимся объектам, сохраняются; очистка доступной части при этом считается завершённой. Код, название, настройки и проектные списки сохраняются; данные других проектов не меняются. Адресованные пользователю запросы и Telegram-уведомления сохраняются, но ссылки в них на удалённые наблюдения перестают открываться.
Перед очисткой остановите сбор данных и фоновые проверки проекта: уже начатые операции могут завершиться после очистки. Во время очистки новые операции сохранения отклоняются. Состояние доступно в «Информации о проекте». Если очистка завершилась ошибкой, там же можно повторить её; до успешного завершения новые данные в проект не принимаются.
В «Информации о проекте» также видны число доступных вам наблюдений, запросов, уникальных найденных строк и объектов контента, а также оценка размера доступных файлов. Счётчики обновляются по кнопке; состояние очистки обновляется автоматически. Оценка размера не включает версии и файлы без ссылок. Во время удаления файлов текущие счётчики могут уже быть нулевыми — дождитесь состояния «Завершено»; исходный объём очистки показан отдельно.
Удаление проекта
«Удалить проект» очищает доступные вам данные и файлы, затем удаляет сам проект вместе с настройками и проектными списками. Если оставшиеся объекты не позволяют удалить проект, удаление завершится ошибкой. Действие требует подтверждения и выполняется на сервере. При ошибке его можно повторить в окне информации; до завершения код остаётся занятым. После успешного удаления выбор проекта сбрасывается — другой проект автоматически не активируется.
Проектные списки
Проектные списки связывают ручные знания специалиста, автоматические проверки, рекомендации, AI-задачи и Burp Intruder.
| Тип списка | Для чего используется |
|---|---|
ID | Значения идентификаторов, принадлежащих определённому пользователю или сессии. Помогают отличать возможный BOLA/IDOR от обычного межсессионного доступа. Практично создавать отдельные списки userId, accountId, orderId и других предметных идентификаторов. |
PDN | Конкретные значения персональных данных, которые нужно искать в телах ответов при автоматических проверках. Добавляйте известные значения, например тестовый адрес электронной почты; совпадение появится в рекомендации TESTED как предупреждение для ручной оценки. |
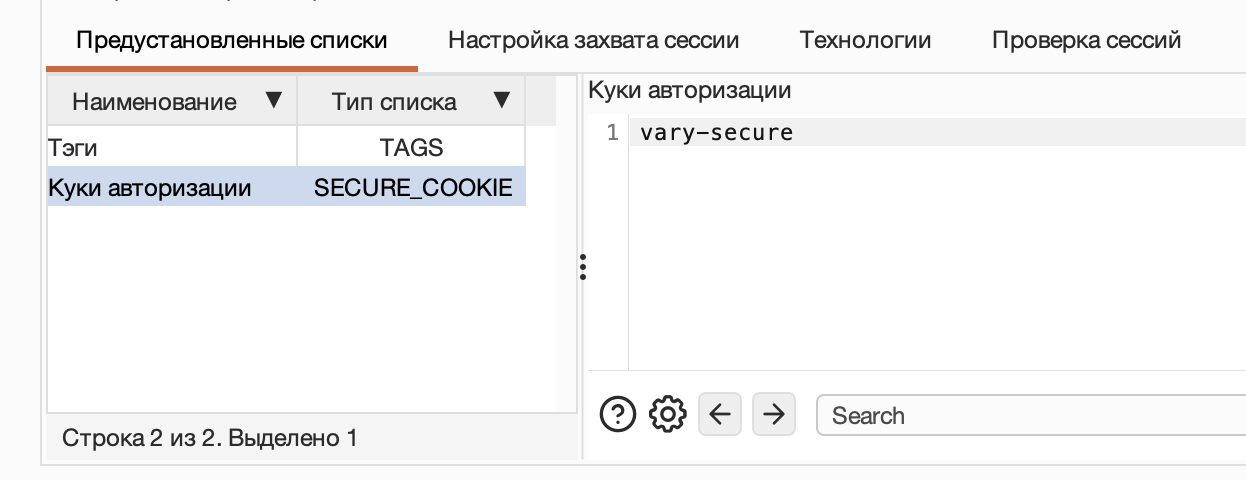
SECURE_COOKIE | Имена cookies авторизации или cookies с чувствительными значениями. Используются при проверках снятия авторизации и отражения секретов. |
SECURE_HEADERS | Имена авторизационных и чувствительных заголовков. Используются при проверках снятия авторизации и исключаются из обычного поиска поддерживаемых заголовков. |
HEADERS | Имена нестандартных заголовков, которые WebVulnFinder проверяет на поддержку исследуемыми API. |
COOKIE | Имена дополнительных cookies для поиска скрытой обработки на разных API. |
PARAMS | Имена скрытых query- и body-параметров, способных изменить поведение приложения: идентификаторы, роли, права, tenant- и статусные признаки. |
HOSTS | Известные origin и хосты проекта. Используются общим переключателем Origin во всех рабочих витринах. |
INTERNAL_URLS | Явно внутренние адреса для будущих проверок SSRF: локальные домены, адреса частной сети и ссылки на внутренние системы. |
BASE_URLS | Базовые URL, от которых начинается обслуживание приложения. Используются при проверке строк PATH_LIKE и поиске новых API. |
TAGS | Набор пользовательских меток для классификации наблюдений и строк. |
INTRUDER | Универсальные пользовательские значения для Burp Intruder без специального значения для автоматического анализа. |
Списки можно создавать, редактировать и наполнять по мере исследования. Рекомендации предлагают подтверждённые значения для HOSTS, BASE_URLS, PARAMS, ID, HEADERS и COOKIE, но решение о сохранении остаётся за пользователем.
Для тестов авторизации начните с имён чувствительных cookies в SECURE_COOKIE и нестандартных заголовков в SECURE_HEADERS. Имена, а не текущие значения токенов, помогут проверкам отличить данные авторизации от обычного ввода.
Новые элементы PARAMS, HEADERS и COOKIE сначала участвуют в discovery-проверках. Если приложение реагирует на новый вход, его следует зафиксировать в обычном трафике, дождаться обновления API-наблюдения и повторно запустить тесты. Так детальные проверки получают корректный исходный запрос и используют общий механизм дедупликации.
Настройки активных проверок
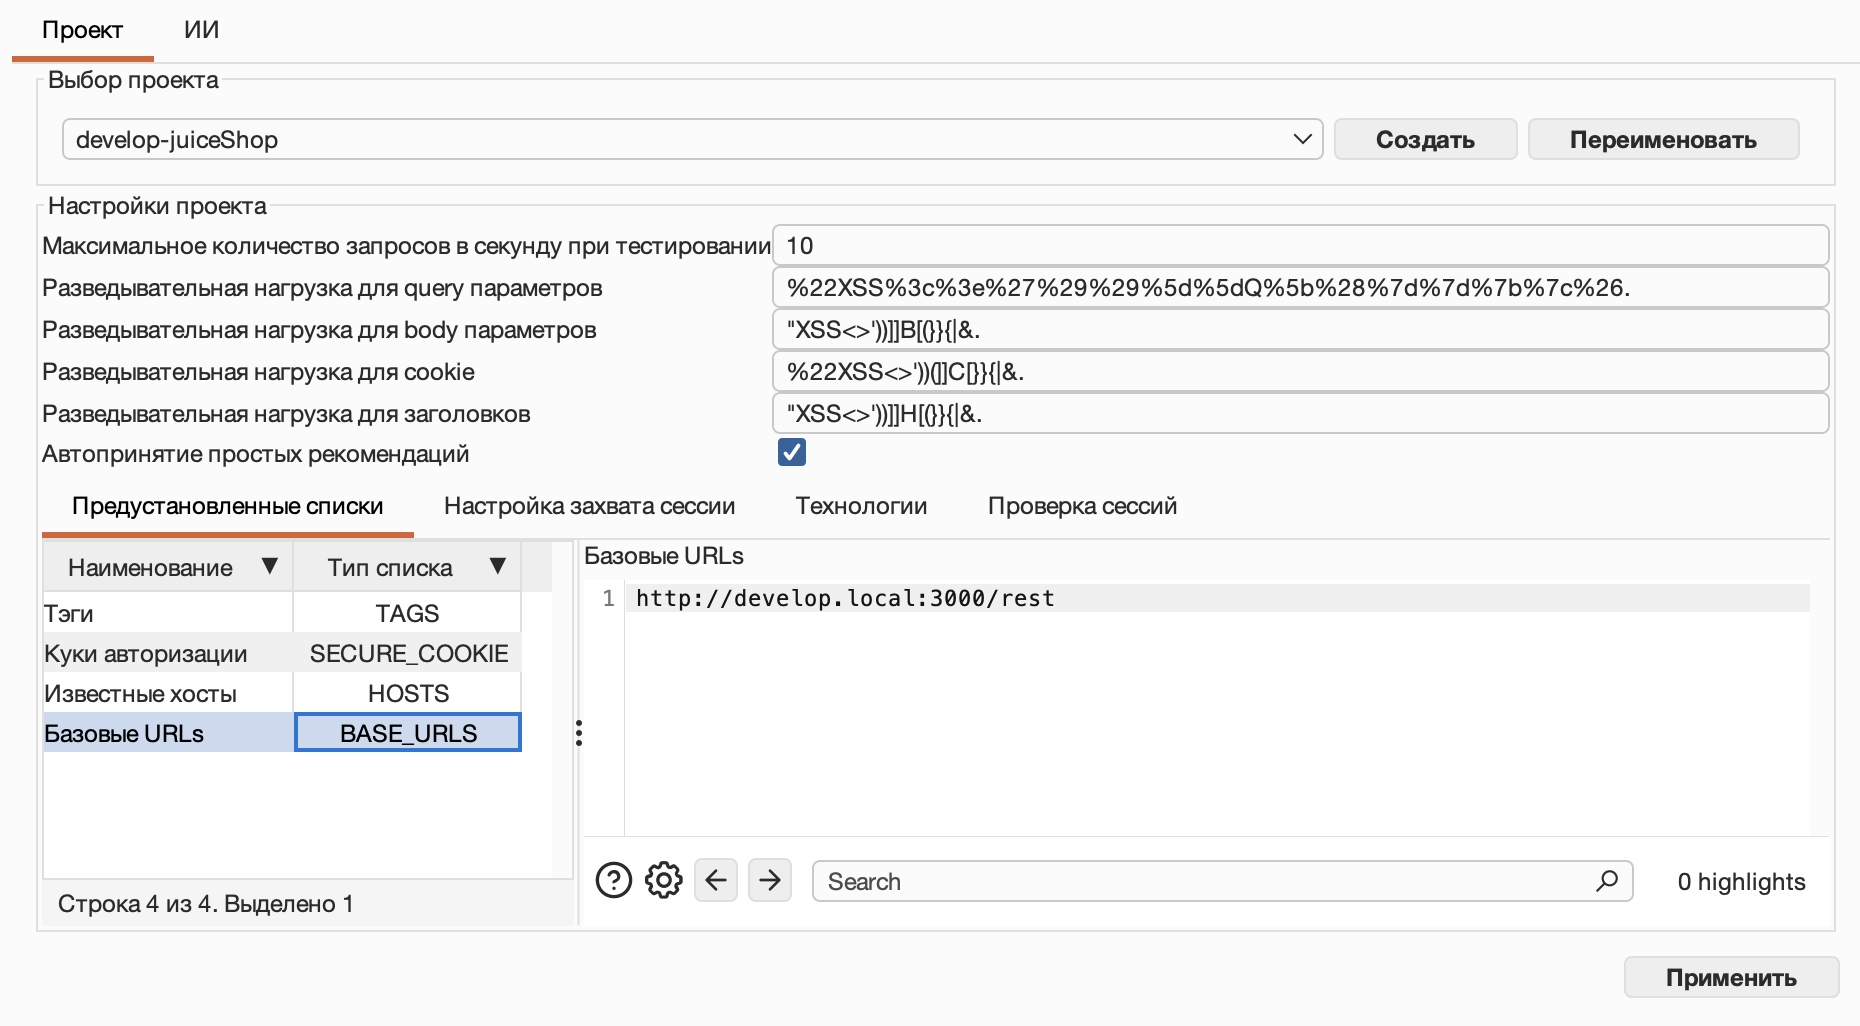
На уровне проекта задаются:
- максимальное число тестовых запросов в секунду;
- диагностические значения для discovery query-параметров;
- значения для дополнительных полей body;
- значения для поиска поддерживаемых заголовков и cookies.
Discovery-значение должно проходить WAF и другие автоматические блокировки, но содержать достаточно допустимых управляющих и специальных символов, чтобы обработка неизвестного входа могла дать отличимый ответ. Один согласованный набор делает результаты разных API и окружений сопоставимыми.
Технологии
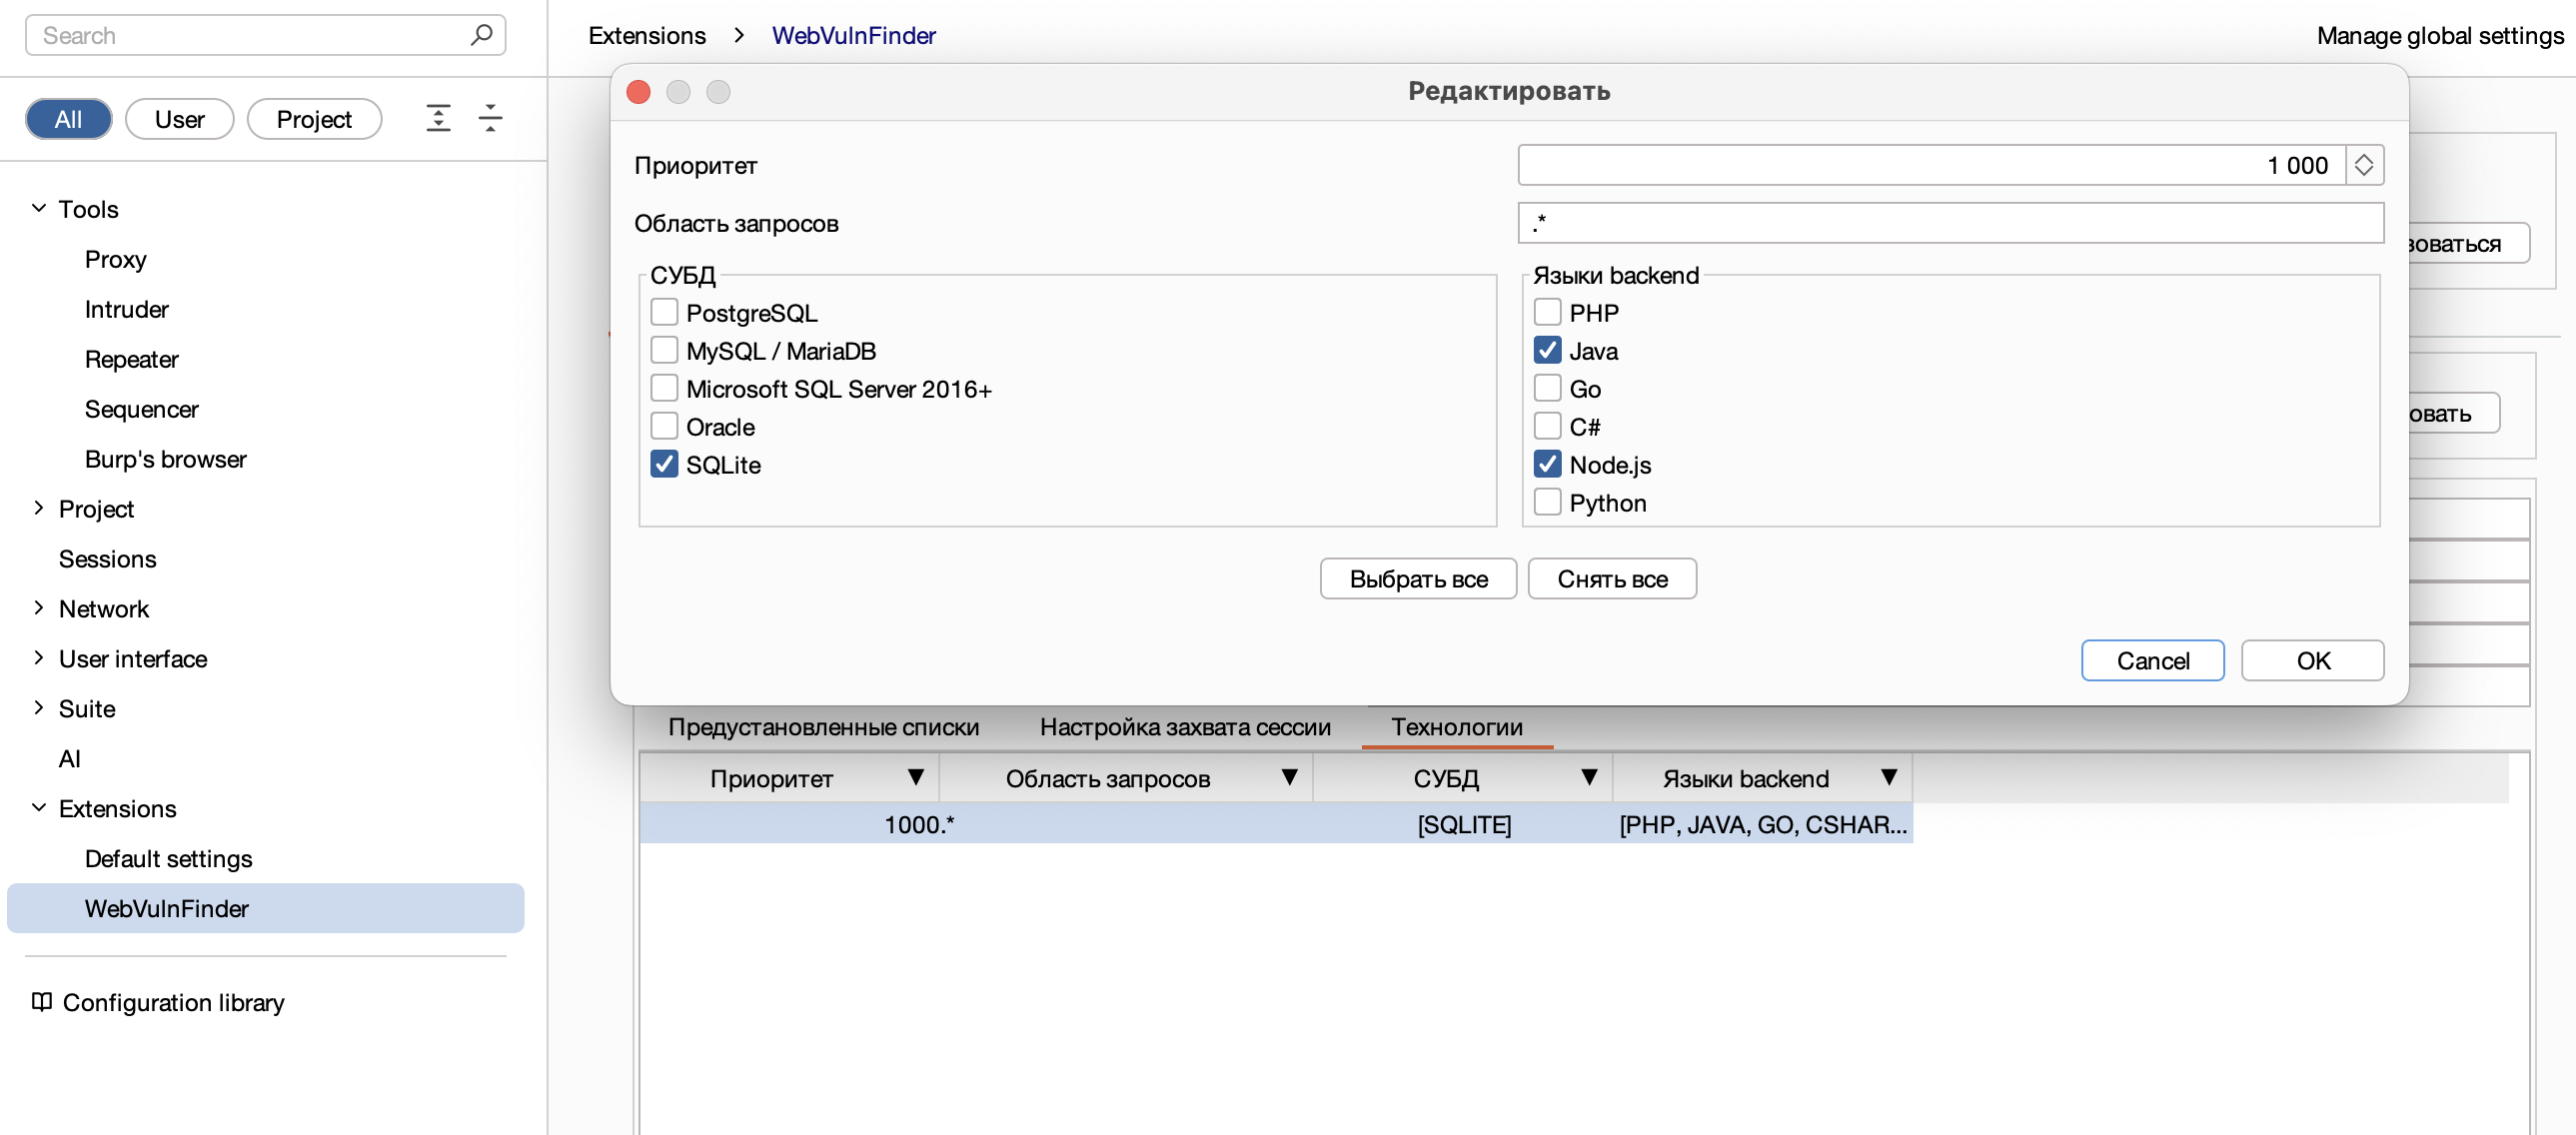
Вкладка «Технологии» позволяет указать СУБД и языки backend, которые могут обслуживать разные области приложения. Правило содержит числовой приоритет, регулярное выражение для URL и ContextPath и перечень технологий. Правила проверяются по возрастанию приоритета; применяется первое полное совпадение. Это позволяет, например, назначить Java и Oracle для legacy API, а Python и PostgreSQL — для /v2/.
Универсальное правило .* создаётся автоматически. Его область нельзя изменить, а само правило нельзя удалить; приоритет и списки технологий доступны для редактирования. Пустой список СУБД отключает зависящие от СУБД проверки, а пустой список языков не генерирует SSTI-нагрузки в соответствующей области.
Использование списков в Burp Intruder
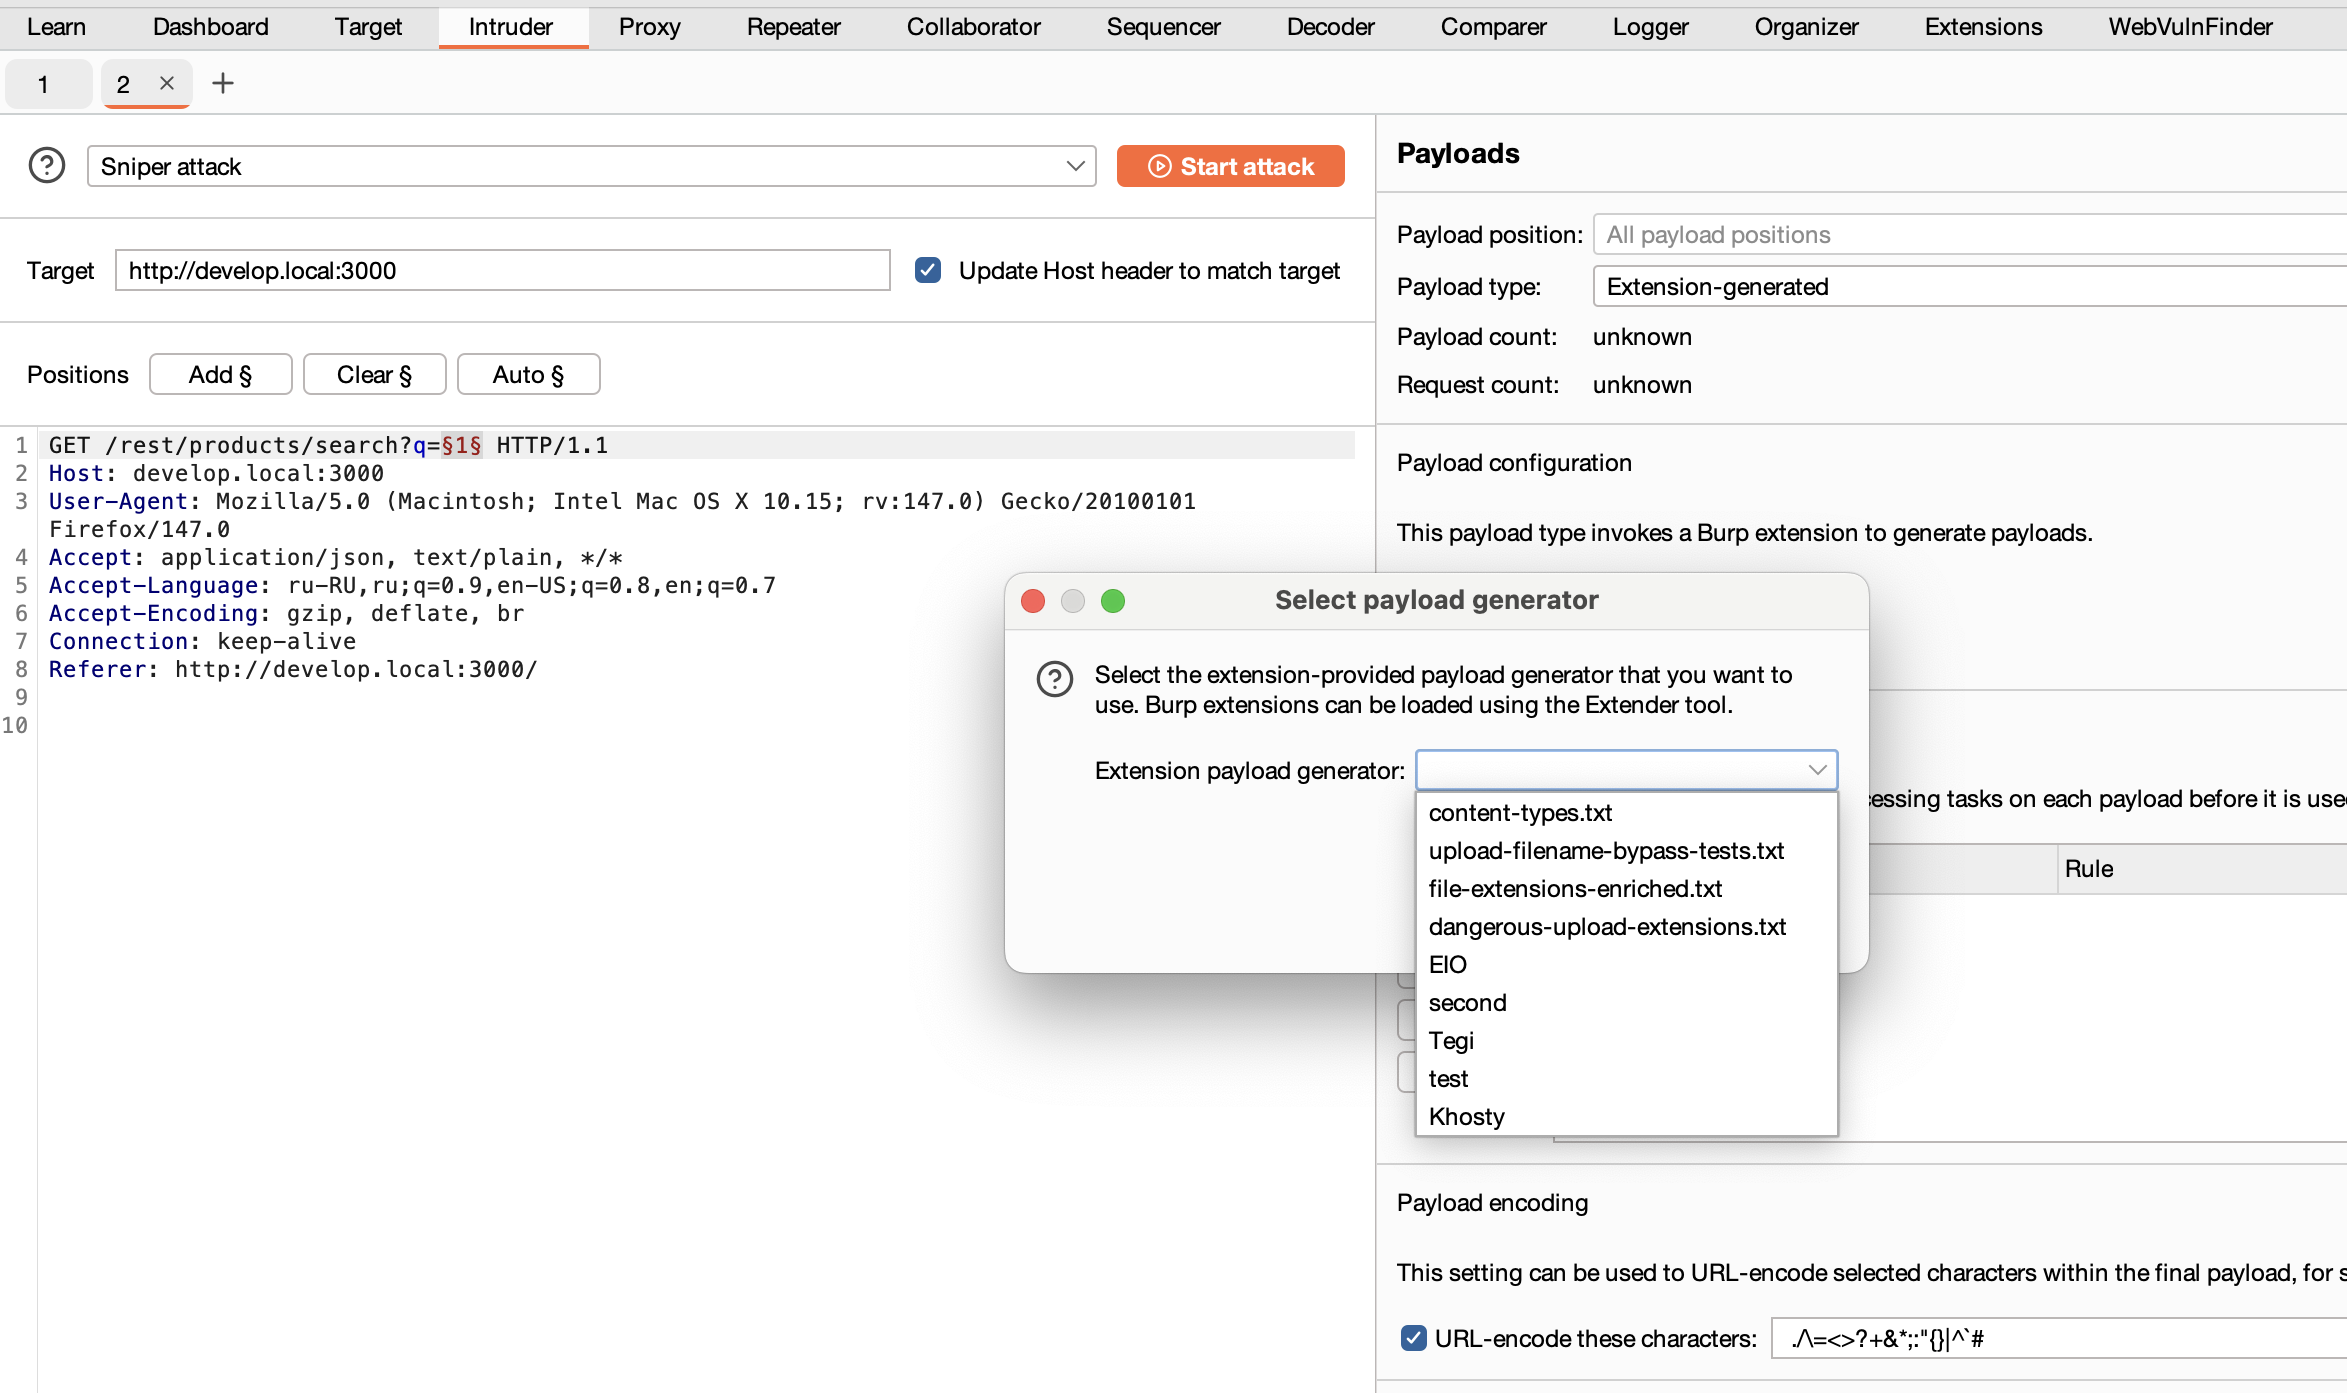
Любой непустой проектный список становится источником payloads в Burp Intruder. В поставку также входят готовые словари Content-Type, потенциально опасных расширений, распространённых расширений файлов и вариантов имён для проверки обхода ограничений загрузки.
Перед запуском проверяйте настройки Payload encoding в Intruder. Это особенно важно для уже закодированных последовательностей, traversal-фрагментов, Unicode, управляющих символов и шаблонных конструкций, которые должны дойти до приложения без дополнительного экранирования.